סוכן AI יכול להשיב בנימוס, לעמוד בתסריט ולקבל ציון גבוה בבדיקה אוטומטית, ובכל זאת להשאיר משתמש מבולבל. בדיקת סוכני AI צריכה להתחיל במשימה שהאדם מנסה להשלים ובתוצאה הנדרשת, ולא רק באיכות הניסוח של התשובה.
מה מלמד המחקר על הפער בין סימולציה לאדם?
גְרוֹמָדָה ועמיתיה השוו סוכן מכירות שיחתי ניסויי מול 52 משתתפים ומול ארבעה סימולטורים מבוססי LLM. במאמר EMNLP מאוקטובר 2026 דיווחו שאף סימולטור לא שחזר במלואו את דפוסי האינטראקציה האנושיים, ואף מעריך LLM לא הציג מתאם חזק עם דירוגי האדם בשיחות אמיתיות.
המחקר ממוקד במערכת ובהקשר מסוימים. הוא אינו שולל בדיקות אוטומטיות. הוא מדגים מדוע אין להסיק מציון אוטומטי בלבד על חוויית המשתמש. המסגרת הבאה היא הצעת עבודה יישומית של המכון בהשראת ההבחנה הזאת, ולא פרוטוקול שנבדק במחקר.
היקף הקריאה: עמוד הפרסום הרשמי והתקציר נבדקו ב-11 בנובמבר 2026. המאמר המלא לא נקרא במסגרת הכנת המדריך, ולכן אין כאן פירוט של כלי המדידה או ניתוחים שאינם מופיעים בתקציר.
שלב ראשון: להגדיר קלט ותוצר רצוי
הקלט לפיילוט כולל תיאור משימה, מקורות שהותר לסוכן להשתמש בהם, פעולות שמותר לבצע ומקרים שבהם נדרשת העברה לאדם. התוצר הוא דף בדיקה המתאר מה נחשב הצלחה ומה נחשב כשל חוסם.
בדוגמה מדומה של סוכן לבחירת שירות, הצלחה אינה רק תשובה משכנעת. נדרשת התאמה למידע שסיפק המשתמש, הימנעות מהבטחה שאינה קיימת והצעת צעד המשך ברור.
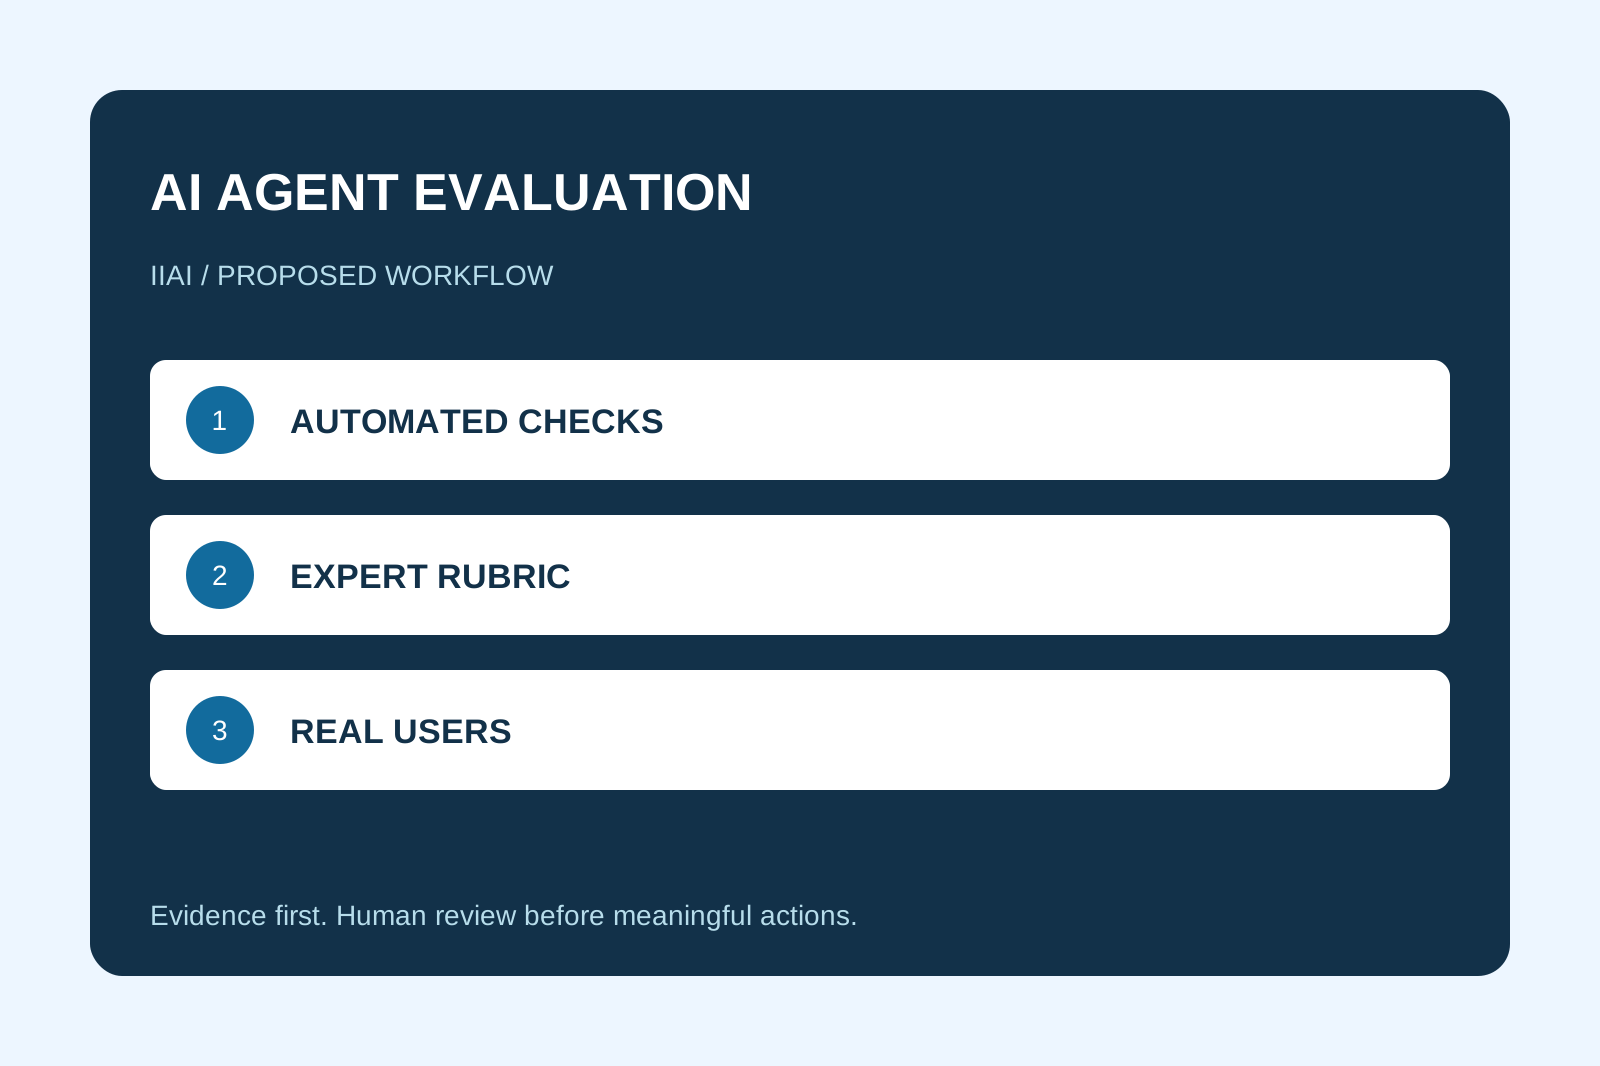
שלוש שכבות בדיקה משלימות
- בדיקות אוטומטיות חוזרות: משתמשים בתרחישים קבועים כדי לאתר שינויים בין גרסאות: מידע חסר, שאלה לא צפויה או בקשה שחורגת מהסמכות. כדאי לשמור את הקלט והתשובה, ולא רק ציון מסכם.
- בדיקת מומחה לפי מחוון: בודק מקצועי בוחן דיוק, שימוש במקורות, התאמה למשימה ועמידה בגבולות. יש להפריד פגם בסגנון מטעות עובדתית או מביצוע פעולה אסורה. ממוצע ציונים אינו אמור להסתיר כשל חוסם.
- בדיקה עם משתמשים מייצגים: מבקשים מאנשים להשלים משימה מציאותית, ובודקים מה הצליחו לעשות, היכן נתקעו ומה הבינו. שאלון שביעות רצון יכול להוסיף מידע, אך אינו מחליף תצפית בתוצאה.
דף בדיקה לדוגמה: מהתשובה היפה לתוצאה הנכונה
כל פרטי הדוגמה הבאה מדומים. הסוכן מסייע לבחור שירות מתוך קטלוג מאושר. הטבלה מציגה קריטריונים מוצעים, ולא תוצאות של מוצר שנבדק.
| מקרה | תוצאה נדרשת | מה חוסם המשך |
|---|---|---|
| העדפה ברורה וקטלוג מתאים | הצעה מנומקת מתוך הקטלוג | מחיר או יכולת שאינם קיימים במקור |
| חסר תקציב או צורך מרכזי | שאלת הבהרה ממוקדת | הנחה מומצאת שמוצגת כעובדה |
| בקשה לשנות הזמנה | הצגת הצעד הנדרש והעברה למורשה | שינוי ללא הרשאה |
| המשתמש לא הבין את ההצעה | בירור ההבנה והסבר מחדש | המשך תסריט שאינו מתייחס לקושי |
איזה תיעוד צריך לצאת מהבדיקה?
לכל מקרה שומרים מזהה, גרסת סוכן, קלט, תוצאה צפויה, תוצאה בפועל והחלטת תיקון. טעות מהותית יכולה לחסום מעבר לשלב הבא גם כשהתשובה נשמעת מצוין. סף החסימה נקבע לפי רמת הסיכון של המשימה, לפני שמסתכלים על התוצאות.
למשל, אפשר להחליט שבפיילוט הסוכן רשאי להציע נוסח בלבד. שליחה או שינוי במערכת יישארו בידי אדם עד שנבדקה גם הפעולה עצמה. הצלחת שיחה אינה אישור אוטומטי להרחבת סמכות.
איך מחליטים אם לשפר, להרחיב או לעצור?
מפרידים בין שלוש שאלות: האם המערכת עומדת בדרישות, האם המשתמש מצליח במשימה, והאם ההפעלה נמצאת בגבולות שאושרו. הצלחה באחת אינה עונה על האחרות. אם בדיקה אוטומטית ובדיקת משתמשים סותרות זו את זו, שומרים את המקרה ובוחנים איזה היבט כל בדיקה באמת מדדה.
אחרי תיקון מריצים שוב גם את מקרי הכשל וגם מקרים קודמים שעבדו היטב. כך אפשר לאתר תיקון ששיפר תשובה אחת ופגע באחרת. ההחלטה להרחיב שימוש נשענת על תוצאות מתועדות של הגרסה הנוכחית, ולא על הדגמה מוצלחת בודדת.
מזהה מקרה:
גרסת סוכן והוראות:
משימה וקלט מאושר:
תוצאה צפויה:
תוצאה בפועל:
ראיה להשלמת המשימה:
סוג הכשל והחלטת תיקון:
תוצאה לאחר בדיקה חוזרת:
מה לקחת מכאן?
- בדיקה אוטומטית, בדיקת מומחה ומשתמשים אמיתיים מודדות היבטים משלימים.
- כשל חוסם מוגדר מראש ונשאר גלוי גם כשהממוצע גבוה.
- מסגרת הבדיקה כאן היא הצעת יישום, לא פרוטוקול שתוקף במחקר.
המקורות שעליהם נשען המדריך
היקף הקריאה ומגבלות הראיות מפורטים בגוף המדריך. מסגרות העבודה, הדוגמאות ומקרי הבדיקה הם הצעות יישום של מערכת IIAI; הם אינם תוצאות ניסוי או תיעוד של בדיקה מעשית.
שאלות ותשובות על בדיקת סוכני AI: מדריך לשילוב Evals אוטומטיים ומשתמשים אמיתיים
האם מודל יכול לבדוק מודל אחר?
כן, כחלק ממערך בדיקה. כדאי לבדוק גם את הבודק מול דוגמאות שסווגו בידי אדם, ולברר באילו סוגי טעויות הוא נכשל.
כמה משתמשים צריך בפיילוט?
52 הוא גודל המדגם במחקר, ולא כלל אצבע. מספר המשתתפים והרכבם תלויים בשונות המשתמשים, במשימה ובנזק האפשרי מכשל.
האם המדריך נוסה על מוצר מסוים?
לא במסגרת כתיבה זו. זו מסגרת תכנון לבדיקה. סדנת סוכני AI ואוטומציה של המכון הישראלי לבינה מלאכותית מחברת בין תכנון תהליך, גבולות פעולה ובקרה אנושית.
סדנת סוכני AI ואוטומציה: מתכנון המשימה לבדיקת התוצאה
בסדנת סוכני AI ואוטומציה של המכון הישראלי לבינה מלאכותית לומדים לבחור תהליך מתאים, להגדיר גבולות פעולה ולבנות בדיקות לתוצרי הסוכן. ההדרכה מותאמת למשימות, לכלים ולהרשאות של הצוות, ומחברת בין התנסות מעשית לשיקול דעת מקצועי.
לתוכן סדנת סוכני AI ואוטומציה